อนาคตของการเรียนรู้เชิงลึกสามารถแบ่งออกเป็น 3 กระบวนทัศน์การเรียนรู้
อนาคตของการเรียนรู้เชิงลึกสามารถแบ่งออกเป็น 3 กระบวนทัศน์การเรียนรู้
การเรียนรู้แบบผสมผสาน ผสมผสาน และลดลง

เว็บไซต์เดิม:
การเรียนรู้เชิงลึกเป็นสาขาวิชาที่กว้างใหญ่ โดยมีศูนย์กลางอยู่ที่อัลกอริทึมซึ่งรูปร่างถูกกำหนดโดยตัวแปรนับล้านหรือหลายพันล้านตัวและมีการเปลี่ยนแปลงอยู่ตลอดเวลา นั่นคือโครงข่ายประสาทเทียม ดูเหมือนว่าทุก ๆ วันจะมีการเสนอวิธีการและเทคนิคใหม่ ๆ จำนวนมาก
อย่างไรก็ตาม โดยทั่วไปแล้ว การเรียนรู้เชิงลึกในยุคปัจจุบันสามารถแบ่งออกเป็นสามกระบวนทัศน์การเรียนรู้พื้นฐาน ภายในแต่ละแนวทางมีแนวทางและความเชื่อที่มีต่อการเรียนรู้ซึ่งมีศักยภาพและความสนใจอย่างมากในการเพิ่มพลังในปัจจุบันและขอบเขตของการเรียนรู้อย่างลึกซึ้ง
การเรียนรู้แบบผสมผสาน — วิธีการเรียนรู้เชิงลึกสมัยใหม่สามารถข้ามขอบเขตระหว่างการเรียนรู้ภายใต้การดูแลและไม่ได้รับการดูแลเพื่อรองรับข้อมูลที่ไม่ได้ติดป้ายกำกับจำนวนมากที่ไม่ได้ใช้งานได้อย่างไร
การเรียนรู้แบบผสมผสาน — โมเดลหรือส่วนประกอบต่างๆ สามารถเชื่อมโยงกันด้วยวิธีการที่สร้างสรรค์เพื่อสร้างแบบจำลองคอมโพสิตที่มากกว่าผลรวมของชิ้นส่วนได้อย่างไร
ลดการเรียนรู้ — จะลดขนาดและการไหลของข้อมูลของโมเดลได้อย่างไร ทั้งสำหรับวัตถุประสงค์ด้านประสิทธิภาพและการนำไปใช้งาน ในขณะที่ยังคงพลังการทำนายเท่าเดิมหรือมากกว่า
อนาคตของการเรียนรู้เชิงลึกอยู่ในกระบวนทัศน์การเรียนรู้ทั้งสามนี้ ซึ่งแต่ละกระบวนทัศน์มีความเชื่อมโยงกันอย่างมาก
การเรียนรู้แบบผสมผสาน
กระบวนทัศน์นี้พยายามที่จะข้ามพรมแดนระหว่างการเรียนรู้ภายใต้การดูแลและการเรียนรู้ที่ไม่ได้รับการดูแล มักใช้ในบริบทของธุรกิจเนื่องจากขาดข้อมูลและมีราคาสูง โดยพื้นฐานแล้ว การเรียนรู้แบบผสมผสานคือคำตอบสำหรับคำถาม
ฉันจะใช้วิธีการภายใต้การดูแลเพื่อแก้ไข/ร่วมกับปัญหาที่ไม่ได้รับการดูแลได้อย่างไร
ประการหนึ่ง การเรียนรู้แบบกึ่งควบคุมดูแลกำลังได้รับความสนใจในชุมชนการเรียนรู้ของเครื่อง เนื่องจากสามารถทำงานได้ดีเป็นพิเศษกับปัญหาภายใต้การดูแลที่มีข้อมูลติดป้ายกำกับเพียงเล็กน้อย ตัวอย่างเช่น GAN (Generative Adversarial Network) ที่ได้รับการออกแบบมาอย่างดีได้รับความแม่นยำมากกว่า 90% ในชุดข้อมูล MNIST หลังจากเห็น ตัวอย่างการฝึกอบรมเพียง 25 ตัวอย่าง.
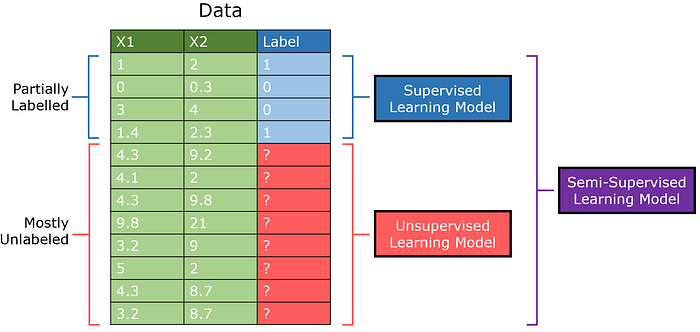
การเรียนรู้แบบกึ่งควบคุมดูแลได้รับการออกแบบมาสำหรับชุดข้อมูลที่มีข้อมูลที่ไม่ได้อยู่ภายใต้การดูแลจำนวนมาก แต่มีข้อมูลภายใต้การดูแลจำนวนเล็กน้อย ในขณะที่รูปแบบการเรียนรู้ภายใต้การดูแลแบบดั้งเดิมจะได้รับการฝึกอบรมในส่วนของข้อมูลและแบบจำลองที่ไม่ได้รับการดูแลในอีกด้านหนึ่ง โมเดลกึ่งภายใต้การดูแลสามารถรวมข้อมูลที่ติดป้ายกำกับเข้ากับข้อมูลเชิงลึกที่ดึงมาจากข้อมูลที่ไม่มีป้ายกำกับ
GAN กึ่งควบคุม (ย่อมาจาก SGAN) เป็นการปรับมาตรฐาน โมเดลเครือข่ายปฏิปักษ์ทั่วไป. discriminator ทั้งสองเอาต์พุต 0/1 เพื่อระบุว่ารูปภาพถูกสร้างขึ้นหรือไม่ แต่ยังส่งออกคลาสของรายการด้วย (การเรียนรู้หลายเอาต์พุต)
สิ่งนี้เกิดขึ้นจากแนวคิดที่ว่าด้วยเครื่องมือจำแนกแยกแยะระหว่างภาพจริงและภาพที่สร้างขึ้น จึงสามารถเรียนรู้โครงสร้างของภาพเหล่านั้นได้โดยไม่ต้องใช้ฉลากที่เป็นรูปธรรม ด้วยการเสริมแรงเพิ่มเติมจากข้อมูลที่ติดฉลากจำนวนเล็กน้อย โมเดลกึ่งควบคุมสามารถบรรลุประสิทธิภาพสูงสุดด้วยข้อมูลภายใต้การดูแลจำนวนน้อยที่สุด
คุณสามารถอ่านเพิ่มเติมเกี่ยวกับ SGAN และการเรียนรู้กึ่งควบคุมได้ ที่นี่.
GAN มีส่วนร่วมในด้านอื่นของการเรียนรู้แบบผสมผสาน - ปกครองตนเอง การเรียนรู้ซึ่งปัญหาที่ไม่ได้อยู่ภายใต้การดูแลจะถูกจัดวางอย่างชัดเจนว่าเป็นปัญหาภายใต้การดูแล GAN ปลอมแปลงข้อมูลภายใต้การดูแลผ่านการแนะนำตัวสร้าง ป้ายกำกับถูกสร้างขึ้นเพื่อระบุภาพจริง/ที่สร้างขึ้น จากหลักฐานที่ไม่ได้รับการดูแล มีการสร้างงานภายใต้การดูแล
หรือพิจารณาการใช้ ตัวเข้ารหัส-ตัวถอดรหัส สำหรับการบีบอัด ในรูปแบบที่ง่ายที่สุด พวกมันคือโครงข่ายประสาทเทียมที่มีโหนดจำนวนเล็กน้อยอยู่ตรงกลางเพื่อแสดงรูปแบบคอขวดที่บีบอัด สองส่วนที่อยู่ด้านใดด้านหนึ่งเป็นตัวเข้ารหัสและตัวถอดรหัส
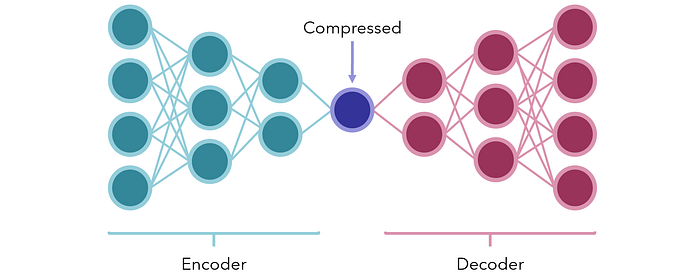
เครือข่ายได้รับการฝึกอบรมในการผลิต เดียวกัน เอาต์พุตเป็นอินพุตเวกเตอร์ (งานภายใต้การดูแลที่สร้างขึ้นโดยไม่ได้ตั้งใจจากข้อมูลที่ไม่ได้รับการดูแล) เนื่องจากมีจุดคอขวดที่จงใจวางไว้ตรงกลาง เครือข่ายจึงไม่สามารถส่งข้อมูลตามลำพังได้ แทนที่จะต้องค้นหาวิธีที่ดีที่สุดในการรักษาเนื้อหาของอินพุตไว้ในหน่วยขนาดเล็กเพื่อให้ตัวถอดรหัสสามารถถอดรหัสได้อีกครั้งอย่างสมเหตุสมผล
หลังจากผ่านการฝึกอบรมแล้ว ตัวเข้ารหัสและตัวถอดรหัสจะถูกแยกออกจากกัน และสามารถใช้ในการรับข้อมูลที่บีบอัดหรือเข้ารหัสเพื่อส่งข้อมูลในรูปแบบที่เล็กมากโดยมีข้อมูลที่สูญหายเพียงเล็กน้อยหรือไม่มีเลย นอกจากนี้ยังสามารถใช้เพื่อลดมิติข้อมูล
อีกตัวอย่างหนึ่ง ให้พิจารณาข้อความจำนวนมาก (อาจเป็นความคิดเห็นจากแพลตฟอร์มดิจิทัล) ผ่านการจัดกลุ่มหรือ การเรียนรู้ที่หลากหลาย เราสามารถสร้างป้ายกำกับคลัสเตอร์สำหรับคอลเลกชันของข้อความ จากนั้นให้ถือว่าสิ่งเหล่านี้เป็นป้ายกำกับ (โดยมีเงื่อนไขว่าการจัดกลุ่มทำได้ดี)
หลังจากตีความแต่ละคลัสเตอร์แล้ว (เช่น คลัสเตอร์ A แสดงถึงความคิดเห็นที่บ่นเกี่ยวกับผลิตภัณฑ์ คลัสเตอร์ B แสดงถึงการตอบรับเชิงบวก ฯลฯ) สถาปัตยกรรม NLP เชิงลึก เช่น BERT จากนั้นจึงสามารถนำมาใช้เพื่อจัดประเภทข้อความใหม่ลงในคลัสเตอร์เหล่านี้ ทั้งหมดนี้มีข้อมูลที่ไม่มีป้ายกำกับทั้งหมดและมีส่วนร่วมน้อยที่สุดของมนุษย์
นี่เป็นแอปพลิเคชั่นที่น่าสนใจอีกครั้งในการแปลงงานที่ไม่ได้รับการดูแลให้เป็นงานภายใต้การดูแล ในยุคที่ข้อมูลทั้งหมดส่วนใหญ่เป็นข้อมูลที่ไม่ได้รับการดูแล มีคุณค่าและศักยภาพมหาศาลในการสร้างสะพานที่สร้างสรรค์เพื่อข้ามขอบเขตระหว่างการเรียนรู้ภายใต้การดูแลและการเรียนรู้แบบไม่มีผู้ดูแลด้วยการเรียนรู้แบบผสมผสาน
การเรียนรู้แบบผสมผสาน
การเรียนรู้แบบผสมผสานพยายามที่จะใช้ความรู้ไม่ใช่แบบจำลองเดียวแต่จากหลายแบบ เป็นความเชื่อที่ว่าด้วยการผสมผสานหรือการใส่ข้อมูลที่เป็นเอกลักษณ์ ทั้งแบบคงที่และแบบไดนามิก การเรียนรู้เชิงลึกสามารถเข้าใจและประสิทธิภาพได้ลึกซึ้งยิ่งขึ้นอย่างต่อเนื่องมากกว่าแบบจำลองเดียว
การถ่ายโอนการเรียนรู้เป็นตัวอย่างที่ชัดเจนของการเรียนรู้แบบผสมผสาน และตั้งอยู่บนแนวคิดที่ว่าน้ำหนักของแบบจำลองสามารถยืมมาจากแบบจำลองที่ได้รับการฝึกฝนล่วงหน้าในงานที่คล้ายคลึงกัน จากนั้นจึงปรับให้เข้ากับงานเฉพาะ โมเดลฝึกหัดเช่น การเริ่มต้น หรือ VGG-16 สร้างขึ้นด้วยสถาปัตยกรรมและน้ำหนักที่ออกแบบมาเพื่อแยกแยะระหว่างรูปภาพประเภทต่างๆ
ถ้าฉันต้องฝึกโครงข่ายประสาทให้รู้จักสัตว์ (แมว สุนัข ฯลฯ) ฉันจะไม่ฝึกโครงข่ายประสาทเทียมตั้งแต่เริ่มต้น เพราะจะใช้เวลานานเกินไปกว่าจะได้ผลลัพธ์ที่ดี แต่ฉันจะใช้โมเดลที่ได้รับการฝึกมาล่วงหน้า เช่น Inception ซึ่งได้จัดเก็บพื้นฐานของการจดจำภาพไว้แล้ว และฝึกฝนสำหรับยุคเพิ่มเติมสองสามชุดในชุดข้อมูล
ในทำนองเดียวกัน การฝังคำในโครงข่ายประสาท NLP ซึ่งจับคู่คำให้ใกล้เคียงกับคำอื่นๆ ในพื้นที่การฝังมากขึ้น ขึ้นอยู่กับความสัมพันธ์ (เช่น 'apple' และ 'orange' มีระยะห่างน้อยกว่า 'apple' และ 'truck') การฝังที่เตรียมไว้ล่วงหน้า เช่น GloVe สามารถวางไว้ในโครงข่ายประสาทเทียมเพื่อเริ่มต้นจากการทำแผนที่ที่มีประสิทธิภาพของคำไปยังเอนทิตีที่เป็นตัวเลขและมีความหมาย
เห็นได้ชัดว่าการแข่งขันสามารถกระตุ้นการเติบโตของความรู้ได้ ประการหนึ่ง Generative Adversarial Networks ยืมจากกระบวนทัศน์การเรียนรู้แบบผสมโดยการเจาะเครือข่ายประสาทสองเครือข่ายเข้าด้วยกันโดยพื้นฐาน เป้าหมายของผู้สร้างคือการหลอกลวงผู้เลือกปฏิบัติ และเป้าหมายของผู้เลือกปฏิบัติไม่ต้องถูกหลอก
การแข่งขันระหว่างแบบจำลองจะเรียกว่า 'การเรียนรู้แบบปรปักษ์' เพื่อไม่ให้สับสนกับการเรียนรู้แบบปฏิปักษ์ประเภทอื่นที่อ้างถึง การออกแบบอินพุตที่เป็นอันตรายและการใช้ประโยชน์จากขอบเขตการตัดสินใจที่อ่อนแอในแบบจำลอง.
การเรียนรู้แบบปรปักษ์สามารถกระตุ้นแบบจำลอง โดยปกติแล้วจะมีหลายประเภท ซึ่งประสิทธิภาพของแบบจำลองสามารถแสดงได้สัมพันธ์กับประสิทธิภาพของผู้อื่น ยังมีงานวิจัยอีกมากที่ต้องทำในด้านการเรียนรู้ของฝ่ายตรงข้าม โดยที่เครือข่ายปฏิปักษ์โดยกำเนิดเป็นเพียงการสร้างที่โดดเด่นเพียงแห่งเดียวของฟิลด์ย่อย
ในทางกลับกัน การเรียนรู้เชิงแข่งขันนั้นคล้ายคลึงกับการเรียนรู้ของฝ่ายตรงข้าม แต่ดำเนินการในระดับโหนดต่อโหนด: โหนดแข่งขันกันเพื่อสิทธิ์ในการตอบสนองต่อชุดย่อยของข้อมูลที่ป้อนเข้า การเรียนรู้แบบแข่งขันเกิดขึ้นใน 'เลเยอร์การแข่งขัน' ซึ่งชุดของเซลล์ประสาทเหมือนกันหมด ยกเว้นบางน้ำหนักแบบกระจายแบบสุ่ม
เวกเตอร์น้ำหนักของเซลล์ประสาทแต่ละตัวถูกเปรียบเทียบกับเวกเตอร์อินพุตและเซลล์ประสาทที่มีความคล้ายคลึงกันสูงสุด เซลล์ประสาทที่ 'ผู้ชนะรับทั้งหมด' ถูกกระตุ้น (เอาต์พุต = 1) ส่วนอื่นๆ ถูก 'ปิดใช้งาน' (เอาต์พุต = 0) เทคนิคที่ไม่มีผู้ดูแลนี้เป็นองค์ประกอบหลักของ แผนที่จัดระเบียบตัวเอง และ การค้นพบคุณสมบัติ.
อีกตัวอย่างที่น่าสนใจของการเรียนรู้แบบผสมผสานคือin ค้นหาสถาปัตยกรรมประสาท. ในแง่ที่ง่ายกว่า โครงข่ายประสาทเทียม (มักจะเกิดขึ้นอีก) ในสภาพแวดล้อมการเรียนรู้แบบเสริมกำลัง เรียนรู้ที่จะสร้างโครงข่ายประสาทเทียมที่ดีที่สุดสำหรับชุดข้อมูล — อัลกอริทึมจะค้นหาสถาปัตยกรรมที่ดีที่สุดสำหรับคุณ! คุณสามารถอ่านเพิ่มเติมเกี่ยวกับทฤษฎี ที่นี่ และการใช้งานใน Python ที่นี่.
วิธีการทั้งมวลยังเป็นแก่นของการเรียนรู้แบบผสมผสาน วิธีการของวงลึกได้แสดงให้เห็นเป็นอย่างมาก มีประสิทธิภาพและการซ้อนโมเดลแบบ end-to-end เช่น ตัวเข้ารหัสและตัวถอดรหัส ได้รับความนิยมเพิ่มขึ้น
การเรียนรู้แบบผสมผสานส่วนใหญ่กำลังหาวิธีสร้างการเชื่อมต่อระหว่างแบบจำลองต่างๆ โดยมีพื้นฐานมาจากความคิดที่ว่า
โมเดลเดียว แม้ว่าจะมีขนาดใหญ่มาก แต่มีประสิทธิภาพแย่กว่าโมเดล/ส่วนประกอบขนาดเล็กหลายๆ ชิ้น โดยแต่ละรุ่นได้รับมอบหมายให้เชี่ยวชาญในส่วนของงาน
ตัวอย่างเช่น พิจารณางานสร้างแชทบ็อตสำหรับร้านอาหาร

เราสามารถแบ่งมันออกเป็นสามส่วน: การสนทนาที่น่ารื่นรมย์/การพูดคุย การดึงข้อมูล และการดำเนินการ และการออกแบบแบบจำลองเพื่อให้เชี่ยวชาญในแต่ละส่วน อีกทางหนึ่ง เราสามารถมอบหมายแบบจำลองเอกพจน์เพื่อดำเนินการทั้งสามอย่าง
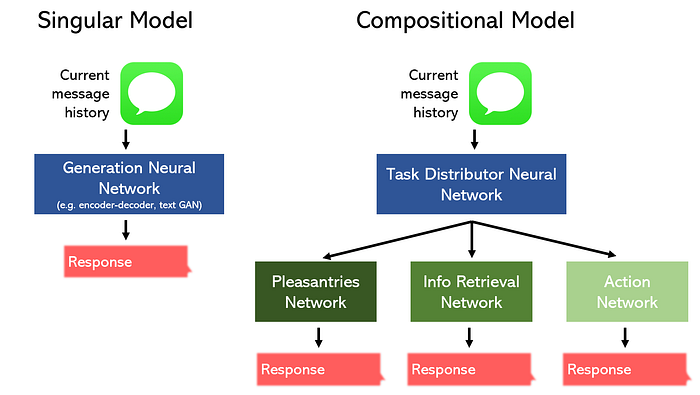
ไม่น่าแปลกใจเลยที่โมเดลการจัดองค์ประกอบจะทำงานได้ดีขึ้นโดยใช้พื้นที่น้อยลง นอกจากนี้ โทโพโลยีที่ไม่เชิงเส้นประเภทนี้สามารถสร้างได้อย่างง่ายดายด้วยเครื่องมือเช่น API ที่ใช้งานได้ของ Keras.
ในการประมวลผลประเภทข้อมูลที่หลากหลายขึ้น เช่น วิดีโอและข้อมูล 3 มิติ นักวิจัยต้องสร้างแบบจำลองการจัดองค์ประกอบที่สร้างสรรค์
อ่านเพิ่มเติมเกี่ยวกับการเรียนรู้องค์ประกอบและอนาคต ที่นี่.
ลดการเรียนรู้
ขนาดของแบบจำลอง โดยเฉพาะอย่างยิ่งใน NLP ซึ่งเป็นศูนย์กลางของความตื่นเต้นเร้าใจในการวิจัยการเรียนรู้เชิงลึกกำลังเติบโตขึ้น โดยมาก. รุ่น GPT-3 ล่าสุดมี175 พันล้าน พารามิเตอร์ เปรียบเทียบกับ BERT ก็เปรียบเสมือนการเปรียบเทียบดาวพฤหัสบดีกับยุง อนาคตของการเรียนรู้เชิงลึกใหญ่ขึ้นหรือไม่?
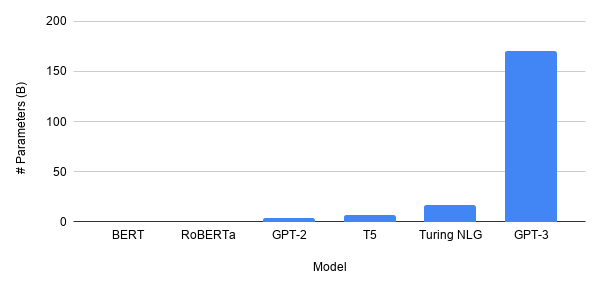
เนื้อหามากไม่มี GPT-3 นั้นทรงพลังมาก เป็นที่ยอมรับ แต่ในอดีตได้แสดงให้เห็นซ้ำแล้วซ้ำเล่าว่า 'วิทยาศาสตร์ที่ประสบความสำเร็จ' เป็นวิทยาศาสตร์ที่มีผลกระทบมากที่สุดต่อมนุษยชาติ เมื่อใดก็ตามที่สถาบันการศึกษาหลงทางไกลจากความเป็นจริง มักจะเลือนหายไปในความมืดมิด นี่เป็นกรณีที่เครือข่ายประสาทถูกลืมไปในช่วงปลายทศวรรษ 1900 เป็นระยะเวลาสั้น ๆ เนื่องจากมีข้อมูลที่มีอยู่เพียงเล็กน้อยจนความคิดถึงแม้จะฉลาด แต่ก็ไร้ประโยชน์
GPT-3 เป็นแบบจำลองภาษาอีกรูปแบบหนึ่ง และสามารถเขียนข้อความที่น่าเชื่อได้ แอปพลิเคชันอยู่ที่ไหน ใช่ มันสามารถสร้างคำตอบให้กับคำถามได้ อย่างไรก็ตาม มีวิธีที่มีประสิทธิภาพมากกว่าในการทำเช่นนี้ (เช่น สำรวจกราฟความรู้และใช้แบบจำลองที่เล็กกว่า เช่น BERT เพื่อแสดงคำตอบ)
ดูเหมือนจะไม่เป็นเพียงกรณีที่ขนาดใหญ่ของ GPT-3 ไม่ต้องพูดถึงรุ่นที่ใหญ่กว่านั้น เป็นไปได้หรือจำเป็นเมื่อพิจารณาจาก ทำให้แห้ง ของพลังการคำนวณ
“กฎของมัวร์กำลังจะหมดแรง”
- สัตยา นาเดลลา, CEO ของ Microsoft
เรากำลังก้าวไปสู่โลกที่ฝังตัวด้วย AI ซึ่งตู้เย็นอัจฉริยะสามารถสั่งซื้อของชำได้โดยอัตโนมัติ และโดรนสามารถนำทางทั้งเมืองได้ด้วยตัวเอง วิธีการเรียนรู้ของเครื่องที่มีประสิทธิภาพควรจะสามารถดาวน์โหลดลงบนพีซี โทรศัพท์มือถือ และชิปขนาดเล็กได้
สิ่งนี้เรียกร้องให้ AI ที่มีน้ำหนักเบา: ทำให้โครงข่ายประสาทเทียมมีขนาดเล็กลงในขณะที่ยังคงประสิทธิภาพไว้
ปรากฎว่าเกือบทุกอย่างในการวิจัยการเรียนรู้เชิงลึกไม่ว่าทางตรงหรือทางอ้อมเกี่ยวข้องกับการลดจำนวนพารามิเตอร์ที่จำเป็นซึ่งไปควบคู่กับการปรับปรุงลักษณะทั่วไปและด้วยเหตุนี้ประสิทธิภาพ ตัวอย่างเช่น การแนะนำเลเยอร์แบบโค้งลดจำนวนพารามิเตอร์ที่จำเป็นสำหรับโครงข่ายประสาทเทียมในการประมวลผลภาพลงอย่างมาก เลเยอร์ที่เกิดซ้ำจะรวมเอาแนวคิดเรื่องเวลาในขณะที่ใช้น้ำหนักเท่ากัน ทำให้โครงข่ายประสาทเทียมประมวลผลลำดับได้ดีขึ้นและมีพารามิเตอร์น้อยลง
การฝังเลเยอร์จะจับคู่เอนทิตีอย่างชัดเจนกับค่าตัวเลขที่มีความหมายทางกายภาพ เพื่อไม่ให้ภาระบนพารามิเตอร์เพิ่มเติม ในการตีความอย่างหนึ่ง ถอนออก เลเยอร์บล็อกพารามิเตอร์อย่างชัดเจนไม่ให้ทำงานในบางส่วนของอินพุต การทำให้เป็นมาตรฐาน L1/L2 ตรวจสอบให้แน่ใจว่าเครือข่ายใช้พารามิเตอร์ทั้งหมดโดยทำให้แน่ใจว่าไม่มีพารามิเตอร์ใดที่ใหญ่เกินไปและแต่ละรายการจะเพิ่มมูลค่าข้อมูลให้สูงสุด
ด้วยการสร้างเลเยอร์เฉพาะ เครือข่ายต้องการพารามิเตอร์น้อยลงสำหรับข้อมูลที่ซับซ้อนและมีขนาดใหญ่ขึ้น วิธีล่าสุดอื่น ๆ พยายามบีบอัดเครือข่ายอย่างชัดเจน
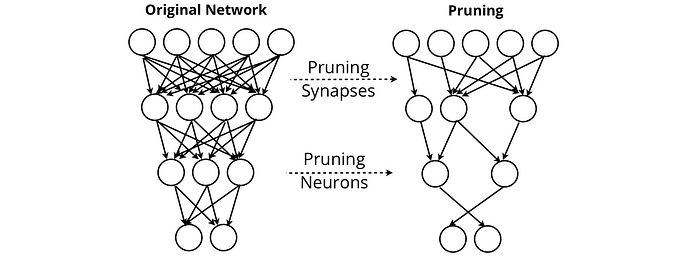
การตัดแต่งโครงข่ายประสาท พยายามที่จะลบไซแนปส์และเซลล์ประสาทที่ไม่ได้ให้คุณค่ากับผลลัพธ์ของเครือข่าย ด้วยการตัดแต่งกิ่ง เครือข่ายสามารถรักษาประสิทธิภาพในขณะที่ลบตัวเองเกือบทั้งหมด
วิธีอื่นๆ เช่น การกลั่นความรู้ของผู้ป่วย หาวิธีบีบอัดโมเดลภาษาขนาดใหญ่ให้อยู่ในรูปแบบที่ดาวน์โหลดได้ เช่น โทรศัพท์ของผู้ใช้ นี่เป็นข้อพิจารณาที่จำเป็นสำหรับ ระบบ Google Neural Machine Translation (GNMT)ซึ่งขับเคลื่อน Google แปลภาษา ซึ่งจำเป็นต้องสร้างบริการแปลภาษาที่มีประสิทธิภาพสูงซึ่งสามารถเข้าถึงได้แบบออฟไลน์
โดยพื้นฐานแล้ว ลดศูนย์การเรียนรู้เกี่ยวกับการออกแบบที่เน้นการปรับใช้เป็นหลัก นี่คือเหตุผลที่การวิจัยเพื่อการลดการเรียนรู้ส่วนใหญ่มาจากแผนกวิจัยของบริษัทต่างๆ แง่มุมหนึ่งของการออกแบบที่เน้นการปรับใช้เป็นศูนย์กลางไม่ใช่การติดตามตัววัดประสิทธิภาพในชุดข้อมูลอย่างสุ่มสี่สุ่มห้า แต่จะเน้นที่ปัญหาที่อาจเกิดขึ้นเมื่อมีการปรับใช้แบบจำลอง
ยกตัวอย่างดังที่กล่าวไปแล้ว อินพุตของฝ่ายตรงข้าม เป็นอินพุตที่เป็นอันตรายซึ่งออกแบบมาเพื่อหลอกลวงเครือข่าย สีสเปรย์หรือสติกเกอร์บนป้ายสามารถหลอกให้รถยนต์ที่ขับด้วยตนเองเร่งความเร็วเกินขีดจำกัดความเร็วได้ ส่วนหนึ่งของการเรียนรู้ที่ลดลงอย่างมีความรับผิดชอบไม่เพียงแต่ทำให้โมเดลมีน้ำหนักเบาเพียงพอสำหรับการใช้งานเท่านั้น แต่ยังทำให้มั่นใจว่าจะสามารถรองรับกรณีมุมที่ไม่ได้แสดงในชุดข้อมูล
การเรียนรู้ที่ลดลงอาจได้รับความสนใจน้อยที่สุดในการวิจัยในการเรียนรู้เชิงลึก เพราะ “เราสามารถบรรลุผลการปฏิบัติงานที่ดีด้วยขนาดสถาปัตยกรรมที่เป็นไปได้” ไม่ได้เกือบจะเซ็กซี่เท่ากับ “เราบรรลุผลการปฏิบัติงานที่ล้ำสมัยด้วยสถาปัตยกรรมที่ประกอบด้วย ของพารามิเตอร์หลายล้านล้านตัว”
ย่อมจะหลีกเลี่ยงไม่ได้ เมื่อการไล่ตามเศษส่วนที่สูงขึ้นจนหมดสิ้นไป ตามประวัติศาสตร์ของนวัตกรรมดังที่แสดงไว้ การเรียนรู้ที่ลดลง ซึ่งเป็นเพียงการเรียนรู้เชิงปฏิบัติเท่านั้น จะได้รับความสนใจมากขึ้นตามสมควร
สรุป
การเรียนรู้แบบผสมผสานพยายามที่จะข้ามขอบเขตของการเรียนรู้แบบมีผู้สอนและแบบไม่มีผู้ดูแล วิธีการต่างๆ เช่น การเรียนรู้แบบกึ่งควบคุมดูแลตนเองสามารถดึงข้อมูลเชิงลึกอันมีค่าจากข้อมูลที่ไม่มีป้ายกำกับ ซึ่งเป็นสิ่งที่มีค่าอย่างไม่น่าเชื่อเมื่อปริมาณข้อมูลที่ไม่ได้รับการดูแลเพิ่มขึ้นแบบทวีคูณ
เมื่องานมีความซับซ้อนมากขึ้น การเรียนรู้แบบผสมจะแยกงานหนึ่งออกเป็นองค์ประกอบที่ง่ายกว่าหลายส่วน เมื่อส่วนประกอบเหล่านี้ทำงานร่วมกัน หรือตรงข้ามกัน ผลลัพธ์ที่ได้คือแบบจำลองที่ทรงพลังกว่า
การเรียนรู้ที่ลดลงไม่ได้รับความสนใจมากนักเนื่องจากการเรียนรู้เชิงลึกกำลังอยู่ในช่วงที่เกินจริง แต่ในไม่ช้า จะมีการออกแบบที่เน้นการใช้งานจริงและการใช้งานจริงได้มากพอ
ขอบคุณที่อ่าน!
คำชี้แจง: สำหรับการแลกเปลี่ยนทางวิชาการเท่านั้น ลิขสิทธิ์ของบทความนี้เป็นของผู้เขียนต้นฉบับ หากมีอะไรผิดพลาดโปรดติดต่อเพื่อลบ